Qu'est-ce qu'un Machine Learning Engineer ?
Un Machine Learning Engineer construit des modèles qui apprennent à partir des données de l'entreprise, puis les fait tourner en production. Son livrable n'est pas un rapport : c'est un service de prédiction appelé par le produit, avec ses temps de réponse et ses alertes.
Il prédit un risque de fraude, classe des images, recommande des articles ou estime un délai de livraison. Dans chaque cas, le modèle est entraîné sur un historique propre à l'entreprise, et c'est ce qui le distingue d'un service acheté sur étagère.
Machine Learning Engineer en français
La traduction officielle de machine learning est apprentissage automatique. « Ingénieur machine learning » circule dans les écoles et les fiches d'orientation. Les entreprises, elles, écrivent ML Engineer dans neuf offres sur dix que nous voyons passer.
Une question revient souvent : quelle différence entre IA et machine learning ? L'IA désigne l'ensemble des techniques qui font accomplir à une machine une tâche jugée intelligente. Le machine learning en est une branche : le programme apprend des exemples au lieu de suivre des règles écrites à la main.
Qui recrute des ML Engineers ?
Les places de marché et les sites marchands en emploient pour la recherche et la recommandation. Les fintechs et les assureurs les placent sur le score de fraude et le risque de crédit. La logistique les utilise pour prévoir la demande et les retards.
Sur nos missions IA, la demande vient surtout de scale-ups de 80 à 800 personnes qui ont déjà des modèles en production. Elles cherchent quelqu'un pour les fiabiliser, pas pour faire un énième prototype.
Les missions d'un ML Engineer
Le poste suit la vie d'un modèle, de la première expérience à son remplacement. Le dosage entre ces tâches dépend de la maturité de l'équipe.
Préparer les données et les features
Une feature est une variable donnée au modèle : nombre de commandes sur trente jours, ancienneté du compte, heure de la transaction. Le ML Engineer écrit le code qui les calcule, et vérifie qu'il produit le même résultat à l'entraînement et en production.
Entraîner et comparer des modèles
Il lance des séries d'entraînements avec PyTorch, XGBoost ou scikit-learn, et consigne chaque essai dans MLflow ou Weights & Biases. Le but n'est pas le meilleur score sur un jeu de test : c'est un modèle qui tient sur les données de la semaine prochaine.
Mettre le modèle en service
Le modèle validé est emballé dans un conteneur, exposé par une API ou lancé en traitement par lots. Le ML Engineer fixe le temps de réponse cible, par exemple 50 millisecondes pour un score affiché au moment du paiement.
Surveiller et réentraîner
Une fois en ligne, le modèle vieillit. Les clients changent, une nouvelle offre arrive, une source de données casse. Le ML Engineer installe les mesures qui détectent ces écarts et décide quand réentraîner.
Une semaine type
Lundi, l'alerte de dérive du modèle de fraude s'allume : une nouvelle carte prépayée fausse la distribution des montants. Mardi, analyse avec l'équipe risque et ajout d'une feature sur le type de carte.
Mercredi et jeudi, réentraînement, puis déploiement du nouveau modèle en mode fantôme à côté de l'ancien. Vendredi, comparaison des deux sur trois jours de trafic et décision de basculer.
Entraîner, déployer, surveiller : la vie d'un modèle en production
En 2015, une équipe de Google publie à NeurIPS l'article « Hidden Technical Debt in Machine Learning Systems ». Sa thèse a fondé le métier : le modèle livre vite des résultats, mais tout ce qui l'entoure coûte cher à maintenir. Le ML Engineer est payé pour cet entourage.
Les trois niveaux de maturité MLOps
Google Cloud décrit trois niveaux dans sa documentation d'architecture sur le MLOps. Nous l'utilisons en entretien pour situer l'équipe d'où vient le candidat.
- Niveau 0, manuel : un Data Scientist entraîne dans un notebook et transmet un fichier de modèle. Les mises à jour sont rares et personne ne mesure la qualité en production.
- Niveau 1, pipeline automatisé : l'entraînement tourne seul, avec validation des données et du modèle. Le réentraînement continu, appelé continuous training, se déclenche sur un calendrier ou sur une baisse de qualité.
- Niveau 2, CI/CD du pipeline : le code du pipeline lui-même est testé et déployé automatiquement, avec registre de modèles, feature store et orchestrateur.
La plupart des entreprises que nous accompagnons se situent entre 0 et 1. Un candidat qui a fait passer une équipe d'un niveau à l'autre a une histoire précieuse à raconter.
Choisir le mode de service
| Mode | Exemple | Contrainte principale |
|---|---|---|
| Par lots (batch) | Score de churn recalculé chaque nuit pour tous les clients | Fenêtre de calcul et fraîcheur des données |
| En ligne (temps réel) | Score de fraude rendu pendant le paiement | Latence de quelques dizaines de millisecondes |
| En flux (streaming) | Détection d'anomalies sur des capteurs | Features calculées au fil des événements |
Par lots (batch)
- Exemple
- Score de churn recalculé chaque nuit pour tous les clients
- Contrainte principale
- Fenêtre de calcul et fraîcheur des données
En ligne (temps réel)
- Exemple
- Score de fraude rendu pendant le paiement
- Contrainte principale
- Latence de quelques dizaines de millisecondes
En flux (streaming)
- Exemple
- Détection d'anomalies sur des capteurs
- Contrainte principale
- Features calculées au fil des événements
Le choix pèse sur toute l'architecture. Un modèle en ligne demande des features disponibles en quelques millisecondes. D'où l'usage d'un feature store comme Feast, qui sert les mêmes valeurs à l'entraînement et en production.
Déployer sans casser
- Mode fantôme (shadow) : le nouveau modèle reçoit le vrai trafic, mais ses réponses ne sont pas utilisées. On compare en silence.
- Canary : 5 % des requêtes passent par le nouveau modèle, puis 25 %, puis tout, si les indicateurs tiennent.
- Test A/B : deux modèles servent chacun une moitié des clients, et on mesure l'effet sur un indicateur métier comme le taux de conversion.
Surveiller la dérive
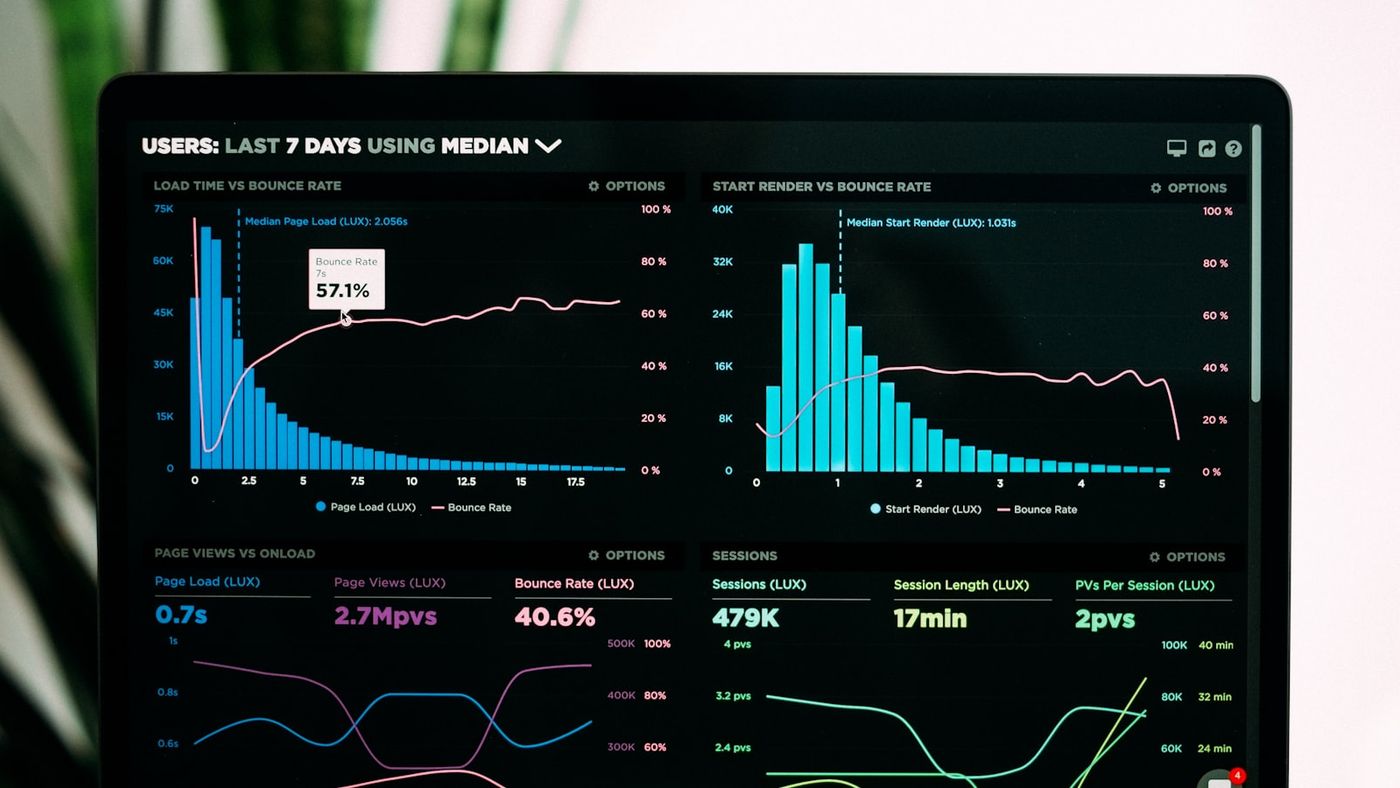
On distingue deux phénomènes. La dérive des données (data drift) : la distribution des entrées change, par exemple l'âge moyen des clients après une campagne. La dérive de concept (concept drift) : le lien entre entrées et résultat change, comme quand les fraudeurs adoptent une nouvelle technique.
La première se voit tout de suite sur les entrées. La seconde n'apparaît qu'une fois les vrais résultats connus, parfois des semaines plus tard pour un impayé. Un bon ML Engineer prévoit des mesures intermédiaires pour ne pas attendre.
Les compétences que nous vérifions en recrutement
Les CV listent tous PyTorch et Kubernetes. Nous cherchons la trace d'un modèle qui a vécu en production, avec ses incidents.
- Code de production : Python testé, typé, relu, empaqueté avec Docker. Le passage du notebook au module est le premier filtre.
- Évaluation honnête : il sait expliquer une fuite de données entre entraînement et test, et pourquoi une validation croisée aléatoire ment sur des données temporelles.
- Service et latence : il connaît le temps de réponse de son dernier modèle, le volume de requêtes par seconde et le coût machine associé.
- Surveillance : il décrit une dérive réellement rencontrée, comment il l'a vue et ce qu'il a changé.
- Cloud et orchestration : au moins une plateforme utilisée pour de vrai, SageMaker, Vertex AI ou Azure ML, et un orchestrateur comme Airflow.
- Dialogue avec le métier : il traduit une précision de 0,92 en euros de fraude évitée ou en clients perdus à tort.
Ce que nous faisons en entretien
Nous montrons au candidat les courbes d'un modèle de prévision de la demande pour une enseigne de distribution : erreur stable pendant six mois, puis hausse brutale sur trois semaines. Il a vingt minutes pour lister les causes possibles et l'ordre dans lequel il les vérifierait. Nous ajoutons ensuite une contrainte : la direction veut un correctif avant vendredi, sans arrêter le modèle actuel.
Salaire d'un Machine Learning Engineer en 2026
À Paris, notre baromètre place un ML Engineer débutant à 40-54 K€ de fixe brut annuel. Un senior touche 64-76 K€. L'écart à l'intérieur de chaque fourchette tient au type d'employeur, à sa taille, au diplôme et surtout au nombre de modèles déjà tenus en production.
Salaire fixe brut annuel à Paris, hors variable
Junior
0-2 ans
40-54 K€
Confirmé
3-5 ans
50-65 K€
Médian : 58 K€
Senior
6-10 ans
64-76 K€
Expert / Lead
10 ans et +
79-97 K€ et plus
Et après ? Au-delà, un Head of AI qui dirige l'équipe ML se situe entre 80 et 98 K€ de fixe au palier senior. Voir le baromètre des salaires
Paris et régions
Hors Île-de-France, retirez de 10 à 15 % au fixe parisien. Lyon se place environ 10 % en dessous. Un poste entièrement à distance pour une entreprise parisienne se négocie souvent autour de 8 % sous la grille.
| Niveau | Paris | Hors Paris |
|---|---|---|
| Junior (0-2 ans) | 40-54 K€ | 34-49 K€ |
| Confirmé (3-5 ans) | 50-65 K€ | 43-59 K€ |
| Senior (6-10 ans) | 64-76 K€ | 54-68 K€ |
| Expert / Lead (10 ans et +) | 79-97 K€ et plus | 67-87 K€ et plus |
Junior (0-2 ans)
- Paris
- 40-54 K€
- Hors Paris
- 34-49 K€
Confirmé (3-5 ans)
- Paris
- 50-65 K€
- Hors Paris
- 43-59 K€
Senior (6-10 ans)
- Paris
- 64-76 K€
- Hors Paris
- 54-68 K€
Expert / Lead (10 ans et +)
- Paris
- 79-97 K€ et plus
- Hors Paris
- 67-87 K€ et plus
Le relevé Glassdoor à Paris
Sur Glassdoor, 251 ML Engineers parisiens déclarent une rémunération totale moyenne de 60 000 €, variable compris. Le quart inférieur se situe sous 50 850 €, le quart supérieur au-dessus de 73 075 €. Les 10 % les mieux payés dépassent 87 900 €.
Le centre de cette distribution correspond à nos paliers Confirmé et Senior. Le haut reflète les bureaux parisiens des grands groupes américains, où les actions gonflent la rémunération totale.
Variable et actions
Le variable pèse en moyenne 12 % du package dans notre baromètre. Selon l'employeur, il prend la forme d'une prime annuelle sur objectifs, ou disparaît au profit de BSPCE en startup. Les filiales de groupes cotés attribuent des RSU, des actions livrées par tranches sur plusieurs années.
Et en freelance ?
Les missions indépendantes existent, surtout pour industrialiser un modèle ou monter une première chaîne MLOps. Un simulateur public de tarifs, travail-industrie.com, avance 600 à 850 € par jour pour un profil de trois à sept ans. Le site ne publie pas sa méthode : prenez-le comme un ordre de grandeur.
Sources : grille Machine Learning Engineer du baromètre Lity (fixe brut à Paris, coefficients par ville) ; Glassdoor, page Machine Learning Engineer à Paris, relevée le 24 octobre 2026 ; simulateur TJM de travail-industrie.com, vérifié en septembre 2026.
Comment devenir Machine Learning Engineer
Le métier demande deux bagages : des mathématiques pour comprendre ce que fait le modèle, et de l'ingénierie logicielle pour le faire tourner. On arrive au poste par l'un ou par l'autre, rarement avec les deux d'emblée.
Les études
La voie courante est un bac+5 : école d'ingénieurs avec une dernière année en data ou en IA, ou master universitaire en apprentissage automatique. Les cours qui servent vraiment sont l'algèbre linéaire, les probabilités, l'optimisation et l'algorithmique.
Le doctorat n'est pas attendu pour ce poste. Il devient un atout dans les équipes qui conçoivent leurs propres architectures, où le métier se rapproche de celui de Research Scientist.
Depuis la data science
Un Data Scientist sait déjà construire et évaluer un modèle. Il lui manque souvent les tests, les conteneurs, le déploiement et la surveillance. Sur les parcours que nous suivons, cette bascule prend un à deux ans quand l'entreprise lui confie un modèle en production.
Depuis le développement backend
Un développeur Python connaît les API, la base de données et les incidents de production. Il doit acquérir les statistiques et la rigueur d'évaluation. Il comble l'écart plus vite s'il commence par des modèles tabulaires, avant le deep learning.
Pour une reconversion, le projet personnel qui convainc ressemble à un vrai service : données publiques, modèle entraîné, API déployée, tableau de dérive. Un score sur une compétition en ligne pèse beaucoup moins.
Évolutions de carrière
Après cinq ans, le ML Engineer choisit entre la profondeur technique, l'encadrement, la plateforme ou un retour vers la recherche.
| Voie | Postes | Fixe à Paris |
|---|---|---|
| Expertise | Senior puis Lead ML Engineer | 79-97 K€ et plus au palier Expert |
| Management | Head of AI, responsable ML | 80-98 K€ pour un Head of AI senior |
| Plateforme | MLOps Engineer, Platform Engineer | 82-99 K€ pour un MLOps Engineer expert |
| Recherche appliquée | Research Scientist | 67-82 K€ au palier senior |
Expertise
- Postes
- Senior puis Lead ML Engineer
- Fixe à Paris
- 79-97 K€ et plus au palier Expert
Management
- Postes
- Head of AI, responsable ML
- Fixe à Paris
- 80-98 K€ pour un Head of AI senior
Plateforme
- Postes
- MLOps Engineer, Platform Engineer
- Fixe à Paris
- 82-99 K€ pour un MLOps Engineer expert
Recherche appliquée
- Postes
- Research Scientist
- Fixe à Paris
- 67-82 K€ au palier senior
Les fiches Head of AI, MLOps Engineer et Platform Engineer détaillent ces suites. Certains rejoignent une équipe qui construit des produits sur des modèles de langage et deviennent AI Engineer.
ML Engineer, Data Scientist ou MLOps Engineer : les différences
Les trois titres se croisent dans les mêmes équipes, et beaucoup d'entreprises de moins de 200 personnes les emploient l'un pour l'autre. Voici comment nous les séparons quand nous rédigeons une offre.
| Critère | ML Engineer | Data Scientist | MLOps Engineer |
|---|---|---|---|
| Question de départ | Comment faire tourner ce modèle de façon fiable ? | Que disent les données sur ce problème ? | Comment outiller toute l'équipe pour livrer ? |
| Livrable | Un modèle servi en production et surveillé | Une analyse, un prototype de modèle | Une plateforme : pipelines, registre, monitoring |
| Part de modélisation | Moyenne à forte | Forte | Faible |
| Fixe confirmé à Paris | 50-65 K€ | 46-58 K€ | 50-65 K€ |
Question de départ
- ML Engineer
- Comment faire tourner ce modèle de façon fiable ?
- Data Scientist
- Que disent les données sur ce problème ?
- MLOps Engineer
- Comment outiller toute l'équipe pour livrer ?
Livrable
- ML Engineer
- Un modèle servi en production et surveillé
- Data Scientist
- Une analyse, un prototype de modèle
- MLOps Engineer
- Une plateforme : pipelines, registre, monitoring
Part de modélisation
- ML Engineer
- Moyenne à forte
- Data Scientist
- Forte
- MLOps Engineer
- Faible
Fixe confirmé à Paris
- ML Engineer
- 50-65 K€
- Data Scientist
- 46-58 K€
- MLOps Engineer
- 50-65 K€
Le Data Scientist explore et prouve qu'un modèle apporte quelque chose. Le ML Engineer le rend exploitable et le garde en état. Le MLOps Engineer construit les outils communs qui permettent à plusieurs ML Engineers de livrer sans réinventer leur chaîne.
L'AI Engineer, lui, part de modèles de langage déjà entraînés par d'autres. Sa fiche explique ce métier voisin ; le ML Engineer reste celui qui entraîne sur les données maison.
Les outils d'un Machine Learning Engineer
La stack combine trois couches : les bibliothèques d'apprentissage, le suivi des expériences et l'infrastructure de service. Les outils changent d'une équipe à l'autre, la logique reste la même.
PythonLangage de référence pour le ML. Sert au training, au serving et aux pipelines de données.
PyTorchStandard du marché en 2026. Utilisé pour entraîner les modèles deep learning et fine-tuner.
MLflowSuivi des expérimentations, versioning des modèles, gestion du registry en production.
Weights & BiasesAlternative SaaS à MLflow. Tracking, comparaison de runs, monitoring des datasets.
DockerPackaging des modèles et de leur environnement d'inférence pour le déploiement.
KubernetesScaling horizontal des serveurs d'inférence, gestion des pods GPU, autoscaling.
AWS SageMakerTraining distribué, endpoints d'inférence managés, feature store sur AWS.
AirflowOrchestration des jobs de training, batch scoring, refresh des features.